Arborescence

Service sur mesure — installation locale

Un assistant IA
qui tourne chez vous,
sous votre nom.

Nous installons un assistant conversationnel qui fonctionne entièrement sur votre matériel — poste de travail ou petit serveur local. Aucune donnée ne part vers un service tiers, aucun abonnement mensuel par utilisateur, et l'interface porte votre marque, pas la nôtre.

Pourquoi local plutôt que cloud

Vos données ne sortent pas de chez vous

Un assistant hébergé chez un tiers veut dire que chaque question posée, chaque document collé, transite par un serveur extérieur. Pour un cabinet, une étude ou une PME qui traite des informations sensibles, ce n'est pas toujours acceptable — et ce n'est souvent pas nécessaire : les modèles ouverts actuels, correctement installés, couvrent la grande majorité des usages courants.

Confidentialité réelle

Le traitement se fait sur votre matériel. Rien ne transite par un service extérieur, pas même pour « améliorer le modèle ».

Fonctionne hors ligne

Une fois installé, l'assistant n'a besoin d'aucune connexion internet pour répondre — utile en cabinet, en atelier, ou en environnement sensible.

Pas d'abonnement par poste

Vous payez l'installation et le paramétrage, pas un tarif mensuel qui grimpe avec le nombre d'utilisateurs.

Sous votre marque

Nom, couleurs, ton des réponses : l'assistant se présente comme le vôtre. Ce qui tourne dessous n'a pas besoin d'être visible pour vos utilisateurs.

Le logiciel installé chez vous

Studio IA Locale V2

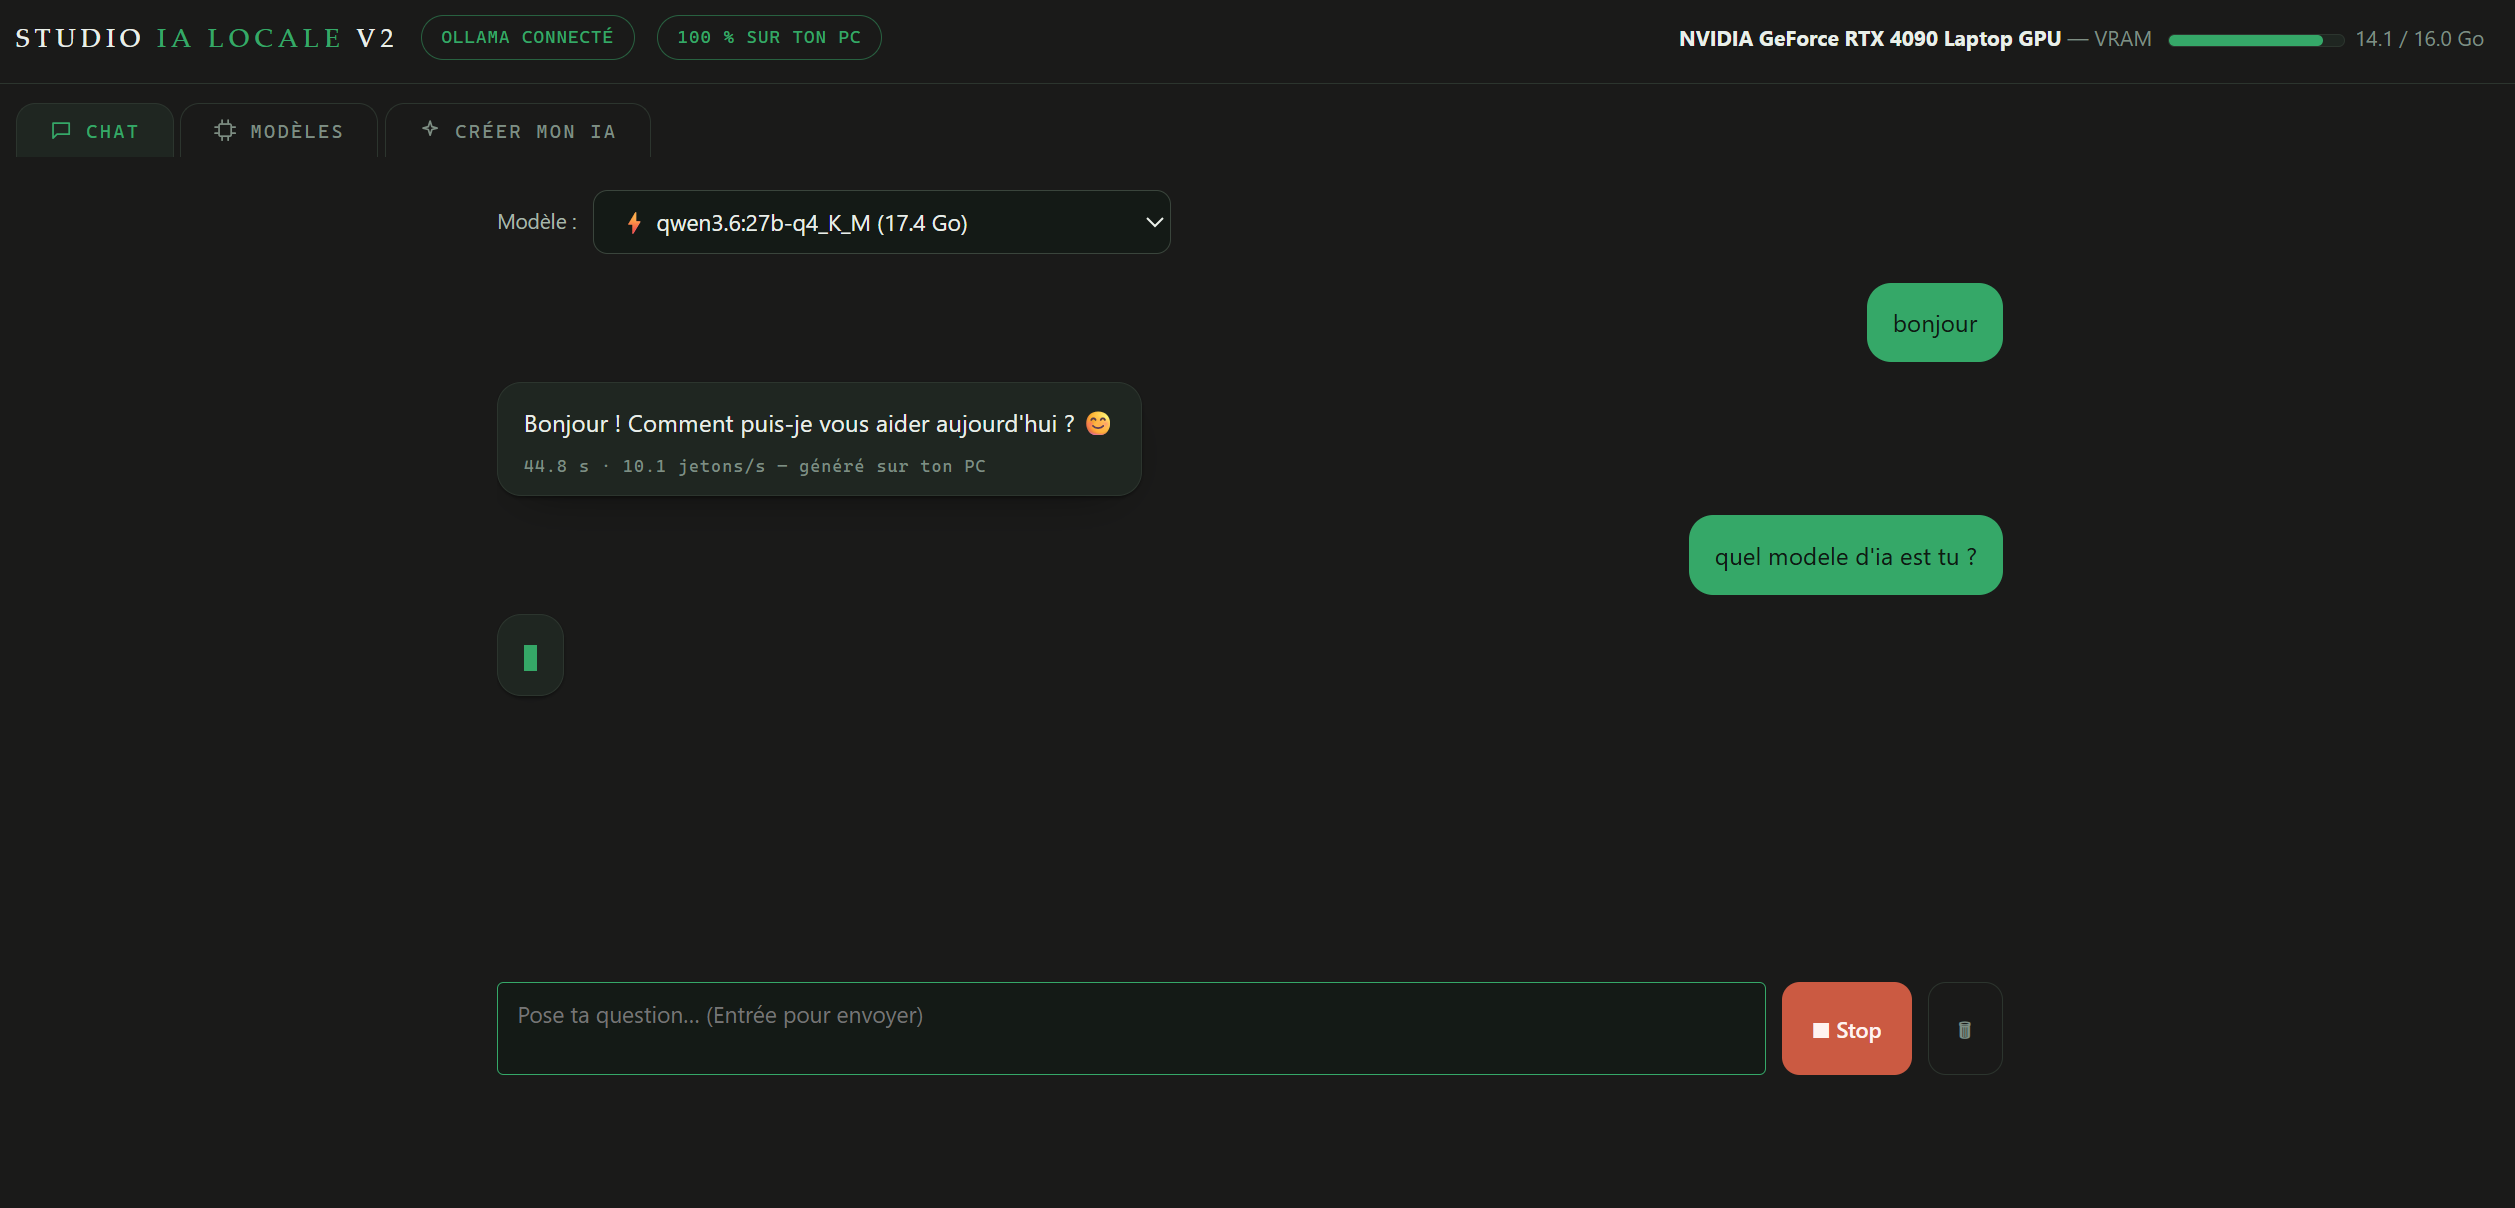
Trois espaces : Chat pour converser avec le modèle installé, Modèles pour gérer ce qui tourne sur votre machine, et Créer mon IA pour donner une personnalité à un modèle de base — un nom, un modèle, un prompt système. C'est la première marche avant un vrai réglage fin (fine-tuning) : suffisant pour la grande majorité des usages métier. Le moteur d'inférence (llama.cpp, open source) tourne intégré dans le logiciel — vos utilisateurs voient votre interface, jamais le nom d'un outil tiers.

Capture d'écran de Studio IA Locale V2 : onglet Créer mon IA, modèle de base qwen3-vl:8b, champ de personnalité
Marque blanche — aucun nom tiers visible 100 % sur votre poste Aucune connexion requise après installation

Ce qu'on installe, concrètement

Deux logiciels, et ils tournent sans Internet

Le premier fait travailler une IA sur votre poste. Le second ne fait que de la voix, et le fait bien. Ils partagent le même moteur : ce qui est téléchargé pour l'un sert à l'autre, et rien n'est jamais envoyé ailleurs.

RACINE

l'atelier complet

Un environnement de travail où l'IA n'est pas une fenêtre de discussion mais un outil : elle lit vos fichiers, exécute des commandes, enchaîne des tâches.

  • Chat avec n'importe quel modèle installé, et un vrai terminal ancré à côté
  • Mode agent — l'IA code, corrige et lance elle-même ce qu'il faut
  • Créer mon IA : un modèle de base, une personnalité, des réglages
  • Voix — elle lit ses réponses à haute voix, et vous lui dictez au micro
  • Recherche web à la demande, jamais en fond, et seulement si vous l'activez
16 modèles de voix 4 modèles de dictée Python seul Hors ligne

VOICE LAB

l'atelier de la voix

Quand on passe une heure sur trois phrases : comparer deux modèles sur le même texte, refaire une prise, découper, ranger. C'est un métier différent, et il demande tout l'écran.

  • Texte vers voix en français, anglais, allemand, espagnol et sept autres langues
  • Clonage de voix à partir de dix secondes d'enregistrement
  • Direction d'acteur — décrire la scène, l'émotion, et le changement de ton en cours de phrase
  • Dictée : le micro écrit dans la zone de texte, transcrit sur la machine
  • Forme d'onde en volume, pilotable au clic, et bibliothèque des prises
Du 27 Mo au 16 Go WAV 16 bits Hors ligne
Ce qu'on mesure avant de vous le proposer. Un modèle n'entre au catalogue qu'après avoir été chronométré sur la machine visée — pas d'après sa fiche technique. Quelques relevés du 26 août 2026, sur une phrase de cinq secondes :
Voix Siwis, française36 × le temps réel
Kokoro, cent voix, sept langues1,4 × le temps réel
Dictée Whisper turbo2,6 × le temps réel

C'est ce genre d'écart — vingt-six fois — qui décide de ce qui tient sur un serveur mutualisé et de ce qui exige votre carte graphique. On vous le dit avant, pas après.

Ce qu'on installe pour vous

Un catalogue de modèles ouverts, classés par ce qu'ils font

Nous ne vous vendons pas « une IA » : nous choisissons, parmi les modèles ouverts qui tournent réellement bien en local aujourd'hui, celui qui correspond à votre usage et à votre matériel — puis nous vérifions qu'il tient dans la mémoire de votre carte graphique avant de le télécharger. Voici les familles que nous installons le plus souvent, avec des tailles et des besoins en VRAM réalistes.

Conversation générale

Rédaction, synthèse, réponses sur vos documents internes, assistant d'accueil.

ModèleTailleVRAM conseilléePour quoi
Phi-3.5 mini (3.8B)2,2 Goléger 4 GoPortable, tourne sur un petit portable sans carte dédiée.
Llama 3.1 8B4,7 Goléger 6 GoGénéraliste solide, le choix par défaut le plus courant.
Mistral 7B4,1 Goléger 6 GoFrançais natif, réponses concises.
Qwen 2.5 14B9 Gomoyen 12 GoMeilleur raisonnement, très bon en français.
Mixtral 8x7B26 Golourd 32 GoQualité nettement supérieure, poste puissant requis.

Vision — comprend une image

Décrire une photo, lire un plan, extraire le texte d'un scan ou d'un PDF image.

ModèleTailleVRAM conseilléePour quoi
Qwen2.5-VL 7B6 Goléger 8 GoLecture de documents scannés et de tableaux photographiés.
Llama 3.2 Vision 11B7,9 Gomoyen 10 GoDescription d'image généraliste, bonne base.
LLaVA 13B8 Gomoyen 10 GoPlus ancien mais éprouvé, large communauté.

Documents longs — recherche dans vos fichiers (RAG)

Interroger des centaines de pages internes sans tout coller dans la conversation.

ModèleTailleVRAM conseilléePour quoi
Nomic Embed Text0,3 Goléger 2 GoIndexe vos documents pour la recherche — pas un modèle de conversation.
Qwen 2.5 32B (contexte 128k)20 Golourd 24 GoGarde en mémoire des dizaines de pages d'un coup.
Command R 35B20 Golourd 24 GoConçu spécifiquement pour citer ses sources documentaires.

Génération d'image

Illustrations, visuels de présentation, maquettes rapides.

ModèleTailleVRAM conseilléePour quoi
Stable Diffusion 3.5 medium~5 Gomoyen 8 GoBon rapport qualité/matériel, le plus souvent installé.
Stable Diffusion XL6,9 Gomoyen 10 GoRéférence stable, large choix de styles.
FLUX.1 [schnell]~12 Golourd 16 GoQualité la plus élevée actuellement, poste puissant requis.

Audio — écoute et transcription

Transcrire une réunion, sous-titrer, dicter un compte-rendu.

ModèleTailleVRAM conseilléePour quoi
Whisper small0,5 Goléger 2 GoTranscription rapide, petit poste, qualité correcte.
Whisper medium1,5 Goléger 4 GoBon compromis vitesse/précision, multilingue.
Whisper large-v33 Gomoyen 6 GoLa plus fiable, y compris en environnement bruyant.

Analyse de code

Relire, documenter, corriger ou générer du code sur vos dépôts internes.

ModèleTailleVRAM conseilléePour quoi
Qwen2.5-Coder 7B4,7 Goléger 6 GoTrès bon rapport taille/qualité pour un poste de développeur.
DeepSeek-Coder-V2 16B9 Gomoyen 12 GoSpécialisé code, bon sur des bases plus larges.
Qwen2.5-Coder 32B20 Golourd 24 GoProche des meilleurs assistants de code fermés.

Et pour les chiffres — comptabilité, tableurs, données ? Il n'existe pas de « modèle comptable » à part : c'est un modèle généraliste (Qwen 2.5 ou Llama 3.1 suffisent) relié à vos outils — votre tableur, votre logiciel de compta, votre base — via des appels de fonction. C'est l'agent et sa connexion à vos outils qui font le travail, pas un modèle spécialement entraîné sur des chiffres. Nous le disons clairement plutôt que de vendre un modèle qui n'existe pas.

Sur le « one-clic ». Le logiciel que vous installez automatise vraiment l'essentiel : détection de votre carte graphique, moteur d'inférence llama.cpp intégré — pas de dépendance externe à poser à part, pas de nom d'outil tiers qui apparaît chez vos utilisateurs — et vérification que le modèle choisi tient dans votre mémoire vidéo avant de le télécharger (au format GGUF, depuis Hugging Face). Ce que nous ne ferons jamais : un bouton sur ce site web qui télécharge et exécute des programmes sur votre machine sans que vous l'ayez lancé vous-même. Ce n'est pas une prudence de notre part que l'on pourrait lever avec une case à cocher — un onglet de navigateur n'a techniquement pas accès à votre système pour exécuter quoi que ce soit, sur aucun site, y compris les nôtres. Le « one-clic » se passe entièrement dans l'installeur du logiciel, un geste que vous lancez vous-même sur votre poste.
Télécharger le bon modèle

Six profils de machine, un fichier à télécharger pour chacun

Le tableau au-dessus classe les modèles par usage. Celui-ci les classe par ce que vous avez sous la main — un téléphone d'entrée de gamme et une tour avec carte graphique ne font pas tourner la même chose. Chaque profil pointe un fichier réel, en un clic, dont le poids affiché est celui du fichier.

Détection de votre appareil…

Téléphone et tablette

La mémoire vive du téléphone est le seul plafond qui compte : le modèle doit y tenir en entier, à côté du système. Comptez large — un téléphone à court de mémoire ferme l'application sans prévenir.

Téléphone · entrée de gamme

2 à 3 Go de mémoire

Qwen 2.5 — 0,5 milliard de paramètres

Le plus petit modèle qui reste utile : il répond, résume et reformule. Il se trompe sur les questions de connaissance et ne raisonne pas en plusieurs étapes — c'est le prix d'un modèle qui tourne sur un appareil d'entrée de gamme.

0,37 Go · Q4_K_M
Télécharger
Téléphone · milieu de gamme

4 à 6 Go de mémoire

Llama 3.2 — 1 milliard de paramètres

Le palier où la conversation devient naturelle et où le français tient sur plusieurs échanges. C'est le meilleur compromis pour la grande majorité des téléphones en circulation.

0,75 Go · Q4_K_M
Télécharger
Téléphone · haut de gamme

8 Go de mémoire ou plus

Qwen 2.5 — 3 milliards de paramètres

Sur un téléphone récent, ce modèle suit une consigne complexe et écrit un français propre. Il chauffe l'appareil et vide la batterie plus vite : c'est un usage par sessions, pas en tâche de fond permanente.

1,80 Go · Q4_K_M
Télécharger

Ordinateur

Sans carte graphique dédiée, le modèle tourne sur le processeur : c'est lent, mais ça marche. Avec une carte, c'est sa mémoire vidéo qui commande, pas celle de la machine.

Ordinateur · entrée de gamme

8 Go de mémoire, pas de carte dédiée

Llama 3.2 — 3 milliards de paramètres

Tourne sur le processeur d'un portable bureautique ordinaire. Comptez quelques mots par seconde à l'écran : lisible en lecture directe, trop lent pour traiter un lot de documents.

1,88 Go · Q4_K_M
Télécharger
Ordinateur · milieu de gamme

16 Go de mémoire, carte de 6 à 8 Go

Qwen 2.5 — 7 milliards de paramètres

Le point d'équilibre de tout le catalogue : assez bon pour du travail réel sur vos documents, assez léger pour une carte graphique de milieu de gamme. C'est ce que nous installons le plus souvent.

4,36 Go · Q4_K_M
Télécharger
Ordinateur · haut de gamme

32 Go de mémoire, carte de 12 Go ou plus

Qwen 2.5 — 14 milliards de paramètres

Le meilleur raisonnement qu'on obtienne sans passer à une machine de calcul. Sur une carte de 12 Go il tient tout juste : si la mémoire déborde, la vitesse s'effondre d'un coup au lieu de baisser progressivement.

8,37 Go · Q4_K_M
Télécharger

Ce qu'un clic fait, et ce qu'il ne fait pas. Le bouton télécharge le fichier du modèle — ça, un navigateur sait le faire, et c'est un fichier de données, pas un programme. Il ne l'installe pas et ne lance rien : il faut ensuite l'ouvrir avec un moteur qui sait lire le format GGUF, celui intégré à notre logiciel ou n'importe quel autre bâti sur llama.cpp. C'est la même limite que celle expliquée plus haut, et elle vaut pour tous les sites, pas seulement le nôtre.

Le déroulé

Quatre étapes, votre matériel du début à la fin

Cadrage de l'usage réel

Répondre à des questions sur vos documents internes, rédiger des synthèses, assister un poste d'accueil — l'usage précis détermine le modèle et le matériel nécessaires, pas l'inverse.

Choix d'un modèle ouvert adapté

Nous sélectionnons parmi les modèles ouverts actuels (Llama, Mistral, Qwen et leurs déclinaisons) celui dont la taille correspond à votre matériel et à la difficulté réelle des tâches demandées.

Installation et habillage

Le moteur d'inférence local est installé et configuré sur votre poste ou votre serveur. L'interface visible par vos utilisateurs porte votre identité — pas de logo ni de nom de tiers technique en avant.

Prise en main et documentation

Une session de prise en main pour votre équipe, et une documentation courte expliquant ce que l'assistant sait bien faire — et ce qu'il ne faut pas lui demander.

Ce que ce service n'est pas. Un modèle qui tourne sur un poste de travail reste plus modeste qu'un service cloud dernier cri sur des tâches très complexes ou du raisonnement long — c'est le compromis contre la confidentialité et l'absence d'abonnement. Nous vous le disons clairement au cadrage, avant tout devis : si votre usage a réellement besoin d'un modèle de pointe hébergé à distance, ce n'est pas l'outil qu'il vous faut, et nous vous le dirons.